מסמך שנשמע רשמי אינו בהכרח קיים
עירייה דחתה בקשה של אב להסעה עבור בנו והסתמכה, בין השאר, על חוזר של משרד החינוך. היו לחוזר שם, סעיפים וציטוטים. אבל כשהצד השני חיפש אותו, הוא לא נמצא. בפסק הדין מ־22 במרץ 2026 קבע בית המשפט העליון בישראל שהחוזר לא קיים ושהעירייה הסתמכה על תוצר של AI בלי בדיקה אנושית מספקת.[1]
מה הייתם בודקים לפני שימוש בתשובה שמצטטת חוזר כזה: האם היא נשמעת סבירה, או האם החוזר נמצא באתר הגוף שהוציא אותו? הסבירות אינה המבחן. מפרקים את התשובה לטענות, מזהים על איזו מהן ההחלטה תלויה, ובודקים דווקא אותה במקור עצמאי. לפעמים זה לוקח דקה; לפעמים אין מקור זמין, ולכן לא מסתמכים על הטענה. המודל הזה הוא דרך מעשית לחלק את מאמץ הבדיקה, לא מבחן שמבטיח שתשובה נכונה.
בקצרה
- בדקו את הטענה שתשנה פעולה או החלטה, לא את מידת הביטחון של התשובה כולה.
- התאימו את הבדיקה למחיר הטעות: מסמך רשמי, מספר מדויק או הוראה מחייבת דורשים מקור מתאים ולא רק קישור שנראה אמיתי.
- זו שיטת עבודה מוצעת, לא כלי שהוכח בניסוי. גם מקור קיים עלול להיות מיושן או לא לתמוך בדיוק בטענה.
כתיבה בטוחה בעצמה אינה ראיה
ניסוי על הדרך שבה אנשים שופטים תשובות של מודלים מצא שהסברים ארוכים העלו את ביטחון הקוראים גם כשהתוספת לא עזרה להם להבחין בין תשובה נכונה לשגויה. זו סיבה להפריד בין איכות הניסוח לבין איכות הראיה. המחקר עסק בשאלות קצרות ובמודלים מסוימים, ולא מדד את הדיוק של כל מוצר כיום.[2]
אמונה נפוצה היא שאפשר לסמוך יותר על תשובה אם היא מפורטת, מציינת מקורות או אינה מהססת. אבל פירוט מוסיף טענות לבדיקה, לא הוכחות. בבדיקה של מרכז Tow, שמונה כלי חיפוש מבוססי AI התבקשו לזהות מאמרי חדשות מתוך קטעי טקסט. יחד הם טעו ביותר מ־60% מ־1,600 השאילתות, ורבות מהתשובות השגויות נוסחו בלי הסתייגות. זהו שיעור בטעות במשימת זיהוי מקורות חדשות שנבדקה בשנת 2025, לא שיעור השגיאות של כל תשובת AI.[3]
גם קישור אינו סוף הבדיקה. פותחים אותו, מוודאים שהוא מוביל למסמך הנכון, ומחפשים בו את המשפט או הנתון שתומך בטענה. אם הקישור מצביע על דף בית, על העתק של פרסום אחר או על מסמך שדן בנושא אך אינו אומר את מה שיוחס לו, הטענה עדיין לא אומתה. מחקר Tow תיעד גם קישורים בדויים והפניות שאינן למקור הנכון.[3]
שלוש בדיקות שנראות כמו אימות, אבל אינן כאלה
״בטוח?״ לא מוסיף ראיה. בניסוי FlipFlop, עשרה מודלים שנבחנו במשימות סיווג שינו תשובה אחרי ערעור ב־46% מהמקרים בממוצע, והדיוק הסופי ירד בממוצע ב־17 נקודות אחוז. אלה מודלים ומשימות מהתקופה שנבדקה, לא אומדן למוצר שאתם משתמשים בו היום. שינוי תשובה הוא סיבה לבדוק, לא הוכחה שהגרסה השנייה נכונה.[4]
הסכמה של מודל שני יכולה להציע כיוון, אך אינה אימות עצמאי: מחקר על יותר מ־350 מודלים מצא שגיאות מתואמות גם בין מודלים של ספקים שונים. במדד אחד, כששני מודלים טעו, הם בחרו באותה תשובה שגויה ב־60% מהמקרים. זה אינו אומדן לשאלה חדשה שלכם; הוא מראה שהסכמה אינה מקור חיצוני.[5]
והבדיקה השלישית? לשאול את אותו כלי ״מאיפה זה?״ ולקבל תשובה עם שמות מאמרים. בפסק הדין בפרשת Mata v. Avianca בארצות הברית תועד שעורך דין שאל את ChatGPT אם פסיקה מסוימת אמיתית; הכלי אישר שהיא אמיתית ואמר שאפשר למצוא אותה במאגרים משפטיים. בית המשפט קבע שהוגשו פסקי דין שלא היו קיימים.[6]
כל טענה מקבלת מסלול משלה
ההצעה שלנו היא מיון טענות: מסמנים רק משפטים שאנשים אחרים עשויים לקבל כעובדה, ושישפיעו על החלטה, פרסום, תשלום או מוניטין. על כל משפט כזה שואלים שתי שאלות: מה מחיר הטעות? וכמה קשה להשיג ראיה חיצונית מתאימה? זהו מודל עריכתי שמחבר עקרונות מוכרים של בדיקת מקורות והתאמת מאמץ למטרה; הוא לא עבר מבחן יעילות מול קבוצת ביקורת.[7]
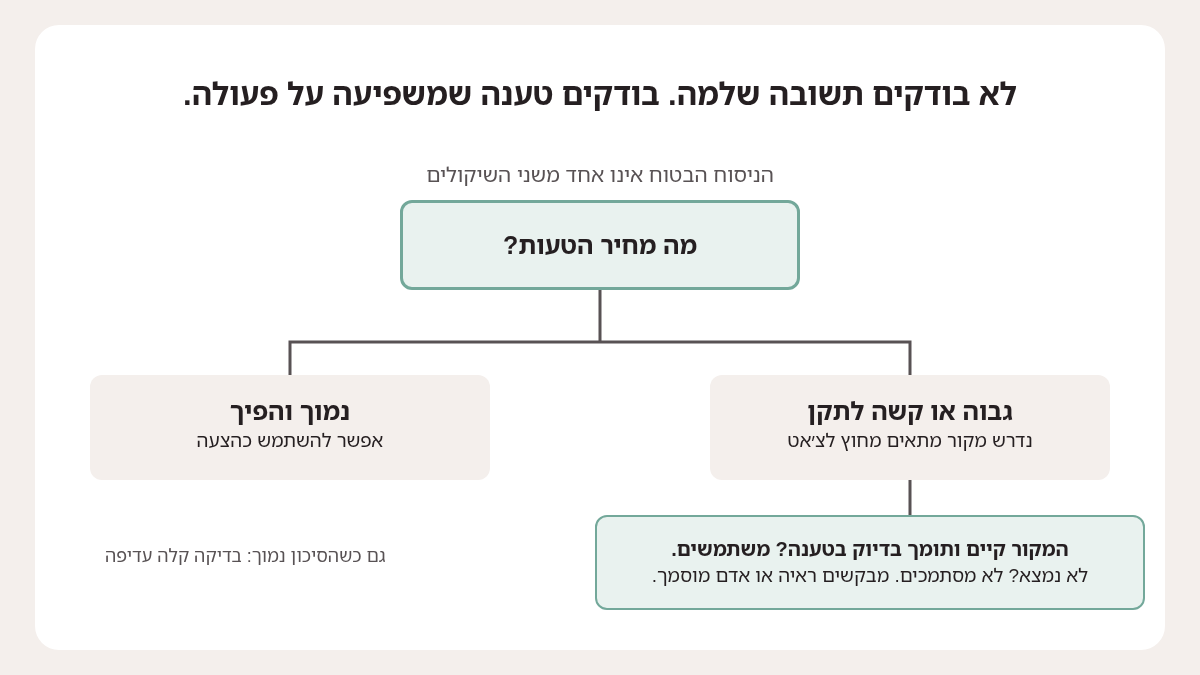
| מחיר הטעות | אפשר לבדוק במקור מתאים מהר? | מה עושים |
|---|---|---|
| נמוך, הפיך | לא חייבים | משתמשים כהצעה, לא כעובדה לפרסום. |
| נמוך, והבדיקה קלה | כן | בודקים את הטענה לפני שמציגים אותה כעובדה. |
| גבוה | כן | בודקים מקור ראשוני ואת ההתאמה המדויקת, כולל תאריך ותחולה. |
| גבוה | לא, או שהמקור לא נמצא | לא מסתמכים; מבקשים מסמך או פונים לאדם מוסמך. |
״קל לבדוק״ לא פירושו להדביק את השאלה שוב בצ׳אט. עבור מספר בתקציב, המקור עשוי להיות טבלה או חשבונית; עבור טענה על חוק, נוסח הדין המעודכן ומי שיכול לפרש את תחולתו; עבור מסמך שמיוחס לרשות, המאגר הרשמי של אותה רשות. הכלל הוא למצוא ראיה שאינה נוצרת מאותו ניסוח AI. שיטת SIFT של מייק קולפילד מציעה לחקור את המקור ולעקוב אחר הטענה עד להקשרה המקורי, תוך התאמת עומק הבדיקה למטרה.[7]
כך מיינו טענות מפסק דין אמיתי
זוהי הדגמה מקורית של שיטת המיון על רשומה קיימת, לא בדיקה חדשה של מודל ולא ניסוי על שיעור השגיאות. לא יצרנו תשובת AI חדשה ולא מייחסים לכלי מסוים ניסוח שלא תועד. נקודת המוצא היא פסק הדין בעניין ההסעה ברמת גן, שנפתח ונקרא במקור הרשמי.[1]
אפשר לדלג לצעדים המעשיים בהמשך
נניח שמסמך שמוצג לנו כולל שלוש טענות: ״קיים חוזר מנכ״ל של משרד החינוך שמסדיר את המקרה״; ״העירייה דחתה את בקשת ההסעה״; ״לכן במקרה שלכם אין זכאות להסעה״. שתי הטענות הראשונות נוגעות למקרה ההיסטורי. השלישית היא כבר מסקנה חדשה על אדם אחר. סיווג כזה חשוב: מקור שמוכיח מה העירייה עשתה בעבר לא מוכיח מה הדין החל על משפחה חדשה.
טענה 1: האם החוזר קיים?
מחיר הטעות גבוה: אם מסתמכים על חוזר שלא קיים, אפשר לדחות בקשה או להציג כלל שלא היה. הבדיקה הישירה היא לא לחפש עוד ניסוח משכנע אלא לאתר את החוזר עצמו במאגר חוזרי המנכ״ל של משרד החינוך[8], או לבקש מהרשות מספר חוזר וקישור למסמך הרשמי. בפסק הדין נכתב שהאב, באמצעות בא כוחו, לא מצא את החוזר, ובהמשך התברר שהוא הומצא בידי AI. את תוצאת המקרה אפשר לאמת בפסק הדין[1]. לא בדקנו אם פונקציית החיפוש באתר החוזרים מזהה כל חוזר, ולכן חיפוש ריק באתר לבדו אינו תמיד ראיה סופית לאי־קיום.
טענה 2: מה באמת החליטה העירייה?
זו טענה היסטורית שאפשר לבדוק ישירות בפסק הדין. שם מופיעים ההליך, עמדת העירייה והחלטת בית המשפט.[1] לכן היא עוברת רק אם הניסוח מצומצם למקרה הזה. לא הופכים אותה למשפט כללי כגון ״כל הרשויות שוללות הסעות במצב הזה״. העלות של בדיקת המסמך נמוכה יחסית למחיר של פרסום הכללה שגויה.
טענה 3: האם הדבר קובע זכאות במקרה אחר?
כאן עוצרים. גם אחרי שהוכחנו מה אירע ברמת גן, שאלת הזכאות במקרה אחר תלויה בפרטי המקרה ובהוראות העדכניות. פסק הדין אינו תחליף לבדיקת הכלל החל על הבקשה החדשה. אם מתכוונים להגיש בקשה, להחליט בשם רשות או לייעץ למשפחה, צריך מקור עדכני לאותה הוראה ובמידת הצורך גורם מוסמך. זו דוגמה למסלול ״לא להסתמך עדיין״, לא מסקנה על הזכאות של הקורא.[1][8]
לפני שמעתיקים, שולחים או מחליטים
- סמנו את הטענות שמשנות משהו. תאריך שקובע מועד, סכום לתשלום, הוראה לציית לה, ייחוס לאדם או ציטוט ממסמך. משפט הסבר כללי שאינו משפיע על פעולה לא צריך אותה רמת בדיקה.
- שאלו מה קורה אם טענה אחת שגויה. אם אפשר לתקן בשקט, התייחסו אליה כהצעה. אם מישהו עלול לפעול לפיה, לעמוד בפני קנס או לקבל החלטה על אדם אחר, אל תשתמשו בה בלי ראיה.
- התאימו מקור לטענה. טבלת נתונים למספר, פסק הדין לטענה על פסק הדין, חוזר רשמי לטענה על חוזר. פתחו את המקור וחפשו בו את המשפט התומך, התאריך והתחולה. אם אין דרך סבירה לבדוק לפני השימוש, השמיטו את הטענה או שאלו מי שאחראי עליה.[7]
אפשר לבקש מהכלי לסמן טענות ולספק קישורים כדי להתחיל, אבל הסימון והקישורים אינם הבדיקה. את המעבר מטענה לראיה עושים מחוץ לתשובה.
מתי המודל הזה לא מספיק
גם מקור אמיתי יכול להיות לא מעודכן או לעסוק במקרה אחר. בדיקה עצמית קצרה אינה תחליף לחוות דעת משפטית, רפואית או מקצועית כשהסיכון גבוה. לפעמים מספר נכון אך המסקנה ממנו שגויה; לפעמים מסמך רשמי קיים אבל אינו חל על האדם, המקום או התקופה שלכם.
מחקרים על ביטחון עצמי, ציטוטים ותשובות מתחלפות נבדקו במשימות, זמנים ומודלים מסוימים. הם אינם מספקים את שיעור השגיאות של הצ׳אט שבו אתם משתמשים היום, וגם לא הוכחה שהמיון שלנו מפחית טעויות בפועל. לגבי השוואה ישירה של אותן שאלות בעברית ובאנגלית בשלושת השירותים לצרכן, לא מצאנו מחקר כזה במקורות שנפתחו; זו מגבלה על החיפוש שערכנו, לא טענה שאין מחקר בעולם. לכן הקפידו על בדיקת טענות מקומיות וחדשות במקור המתאים, בלי להניח שעברית כשלעצמה גורמת לשגיאה.[9]
נסו בעצמכם
בכל מצב בחרו אפשרות אחת, ואז לחצו על ״בדיקת תשובה״ כדי לראות את ההסבר. מעבר על האפשרויות אפשרי גם במקלדת.
הצעד הבא
בחרו תשובת AI אחת שתשתמשו בה השבוע, סמנו טענה אחת שתשנה פעולה, ונסו למצוא לה מקור מתאים. אם לא מצאתם, זו עצמה תשובה שימושית: אל תבנו את ההחלטה על הטענה.
על המאמר
המאמר נכתב על בסיס מחקר בשלושה כלי AI וקריאה ישירה של המקורות המופיעים בהמשך. כלי AI סייעו באיתור ובניסוח; הם אינם מקור לעובדות. מודל מיון הטענות וההדגמה הם הצעה של צוות LearnAI, לא שיטה שנמדדה בניסוי. פורסם ב־25 בספטמבר 2026.
מקורות
- בית המשפט העליון, עע״מ 63194-08-25, נבו בן כהן נ׳ עיריית רמת גן ומשרד החינוך, 22.3.2026, פס׳ 6, 42. פסק הדין הרשמי. נבדק 25.9.2026. מקור ראשוני.
- Steyvers et al., "What large language models know and what people think they know", Nature Machine Intelligence, 21.1.2025. מאמר, DOI: 10.1038/s42256-024-00976-7. נבדק 25.9.2026. מקור ראשוני.
- Jaźwińska & Chandrasekar, Tow Center, "AI Search Has a Citation Problem", Columbia Journalism Review, 6.3.2025. בדיקת המקור. נבדק 25.9.2026. נתוני בדיקה מקוריים.
- Laban et al., "Are You Sure? Challenging LLMs Leads to Performance Drops in The FlipFlop Experiment", arXiv:2311.08596, גרסה 2 מ־21.2.2024. המאמר. נבדק 25.9.2026. מחקר מקורי.
- Kim et al., "Correlated Errors in Large Language Models", ICML 2025, PMLR 267. תקציר המאמר. נבדק 25.9.2026; מאשר מעל 350 מודלים ושגיאות מתואמות. התקציר מאשר גם 60% הסכמה על אותה שגיאה כששני מודלים טעו במדד אחד, לא אומדן לכל שאלה. מקור ראשוני.
- U.S. District Court, Mata v. Avianca, Inc., No. 22-cv-1461, Opinion and Order on Sanctions, 22.6.2023, פס׳ 44-46. החלטת בית המשפט. נבדק 25.9.2026. העתק של רשומה שיפוטית ראשונית.
- Mike Caulfield, "SIFT (The Four Moves)", 19.6.2019. השיטה המקורית. נבדק 25.9.2026. מקור שיטה ראשוני; מודל מיון הטענות הוא ההצעה שלנו, לא ממצא של Caulfield.
- משרד החינוך, מאגר חוזרי מנכ״ל. נבדק 25.9.2026 כנתיב רשמי; תפקוד החיפוש והשלמות לא נבדקו. תיעוד רשמי.
- Islam et al., "How Much Do LLMs Hallucinate across Languages?", EMNLP 2025. המאמר, גרסת arXiv שנפתחה. נבדק 25.9.2026. מודלים פתוחים בלבד, ללא השוואת שלושת מוצרי הצרכן.